yarn产生的背景
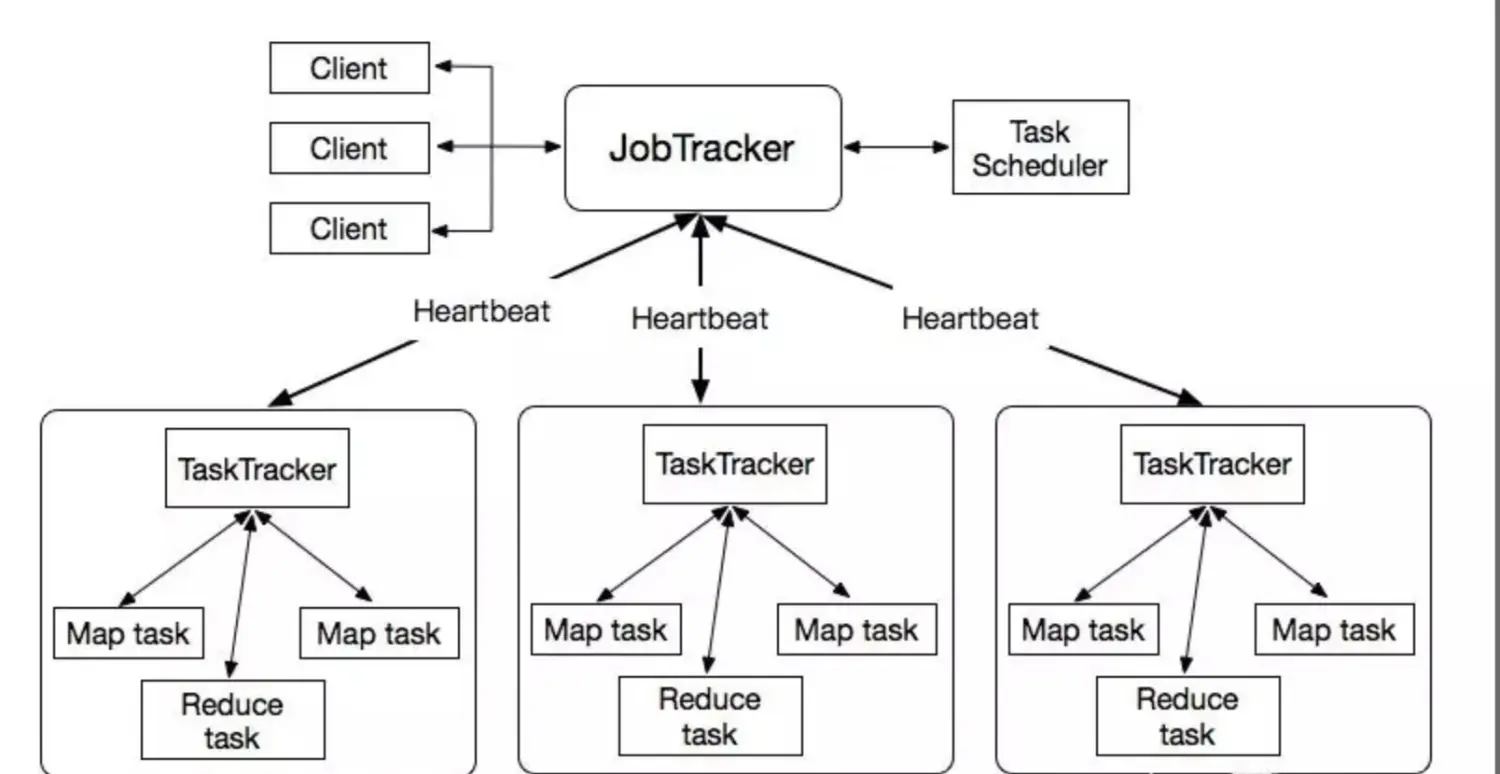
image.png
在没有yarn之前,hadoop使用的是MapReduce1.x,它是一个Master/Slave架构,一个JobTracker带多个TaskTracker,JobTracker是整个架构的核心,我们来看下JobTracker到底要负责哪些事情?
1.接收客户端提交job请求
- 根据job提供的参数向NameNode请求获取这些文件数据存放的DataNode的列表地址,这意味着要和HDFS Metadata Server通信
- JobTracker 要确定job的执行计划,确定执行job的Map Reduce的task数量,并分配到离数据块最近的节点上,所以JobTracker需要确定哪些机器是活的,资源还剩多少,根据资源使用情况和数据分布情况作出分配策略。
- JobTracker提交所有task到每个TaskTracker节点,TaskTracker会定时的向JobTracker发送心跳,若一定时间没收到心跳,JobTracker就默认这个TaskTracker节点挂了,并把这个节点上的task重新分配到其他节点上。
- 监听task的执行情况,当所有task执行完成时,JobTracker会更新job的状态为完成。
- JobTracker将发送job的运行状态信息给Client端。
综合来说,JobTracker既当爹又当妈,既要管理资源,又要做任务调度,这不得活活把自己给累死
对于MapReduce1.x版本的原理和存在的问题可参考前面笔者的探究MapReduce原理
下一代MapReduce框架的基本设计思想就是将JobTracker的两个主要功能,即资源管理和作业控制(包括作业监控、容错等)拆分成两个独立的进程,资源管理进程与具体应用程序分离,它只负责集群的资源(内存、cpu、磁盘)管理,而作业控制进程是直接与应用程序相关的模块,并且每个作业控制进程只负责管理一个作业,这样通过将原有JobTracker中与应用程序相关和无关的模块分开,不仅减轻了jobTracker的负载,也使得hadoop支持其他的计算框架。
从资源管理角度看,下一代MapReduce框架实际上衍生出了一个资源统一管理平台YARN, YARN的基本思想是将资源管理和作业调度/监控的功能分解为单独的守护进程,这包括两个部分,一个是全局的资源调度(ResourceManager RM)和针对每个应用程序的ApplicationMaster(AM), 应用程序可以是长作业,也可以是短作业,这样的分离使得hadoop不再局限于仅仅支持MapReduce一种计算模型,而是可以无限融入多种计算框架,且对这些框架进行统一管理和调度。
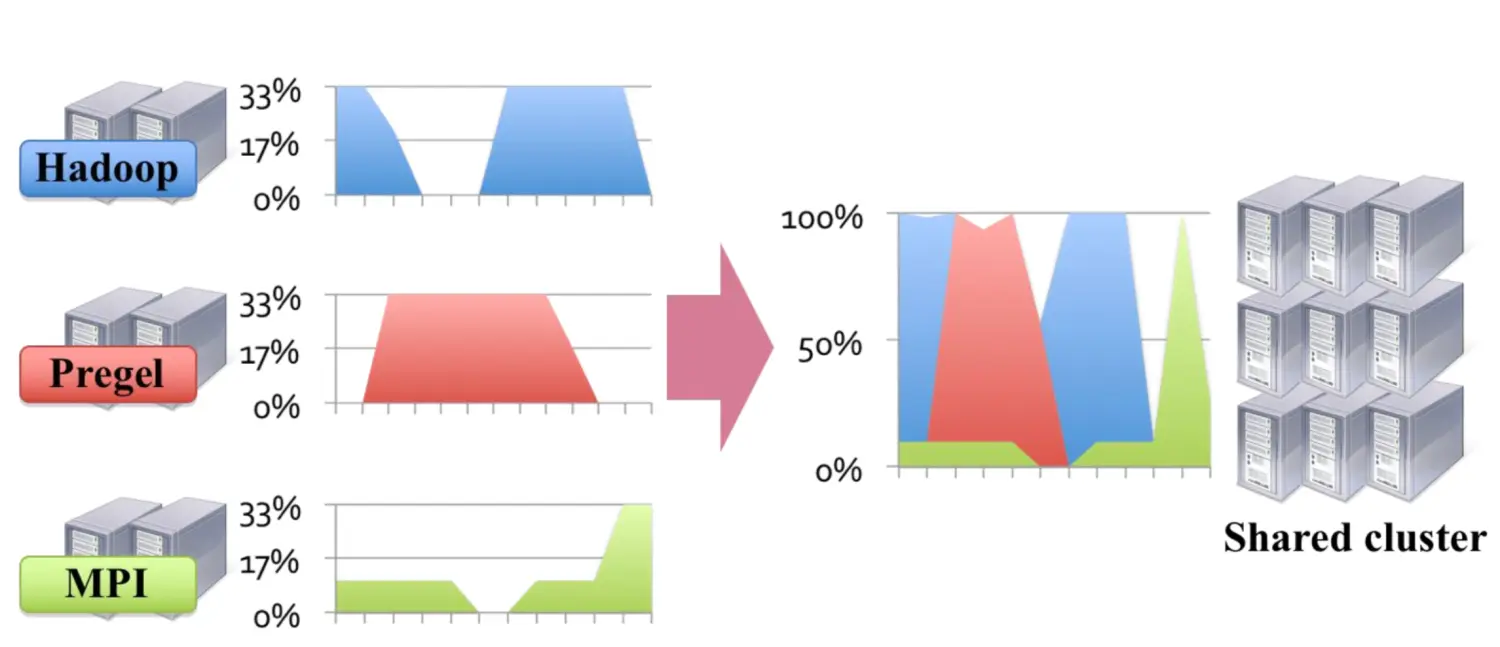
image.png
在yarn产生之前,除了MapReduce,业内已经出现了多种计算框架,比如spark、tez,在yarn之前,这些不同的框架需要跑在不同的集群上,但这些计算框架完全有可能只是一段时间内的计算,这样是对集群资源的浪费,不同的计算框架完全有可能是在不同的时间段工作,那么能不能使用一种通用的架构,使得这些计算框架跑在一个集群上呢? yarn就是做了这样的工作,大大提高了资源的利用率, 另一方面,“一个框架一个集群的模式”有可能需要多个管理员管理这些集群,进而增加运维成本,而共享模式通常只需要少数管理员即可完成多个框架的统一管理。此外,随着数据量的暴增,跨集群间的数据移动不仅需花费更长的时间,并且硬件成本也会大大增加,而共享集群模式可让多种框架共享数据和硬件资源,将大大减小数据移动带来的成本
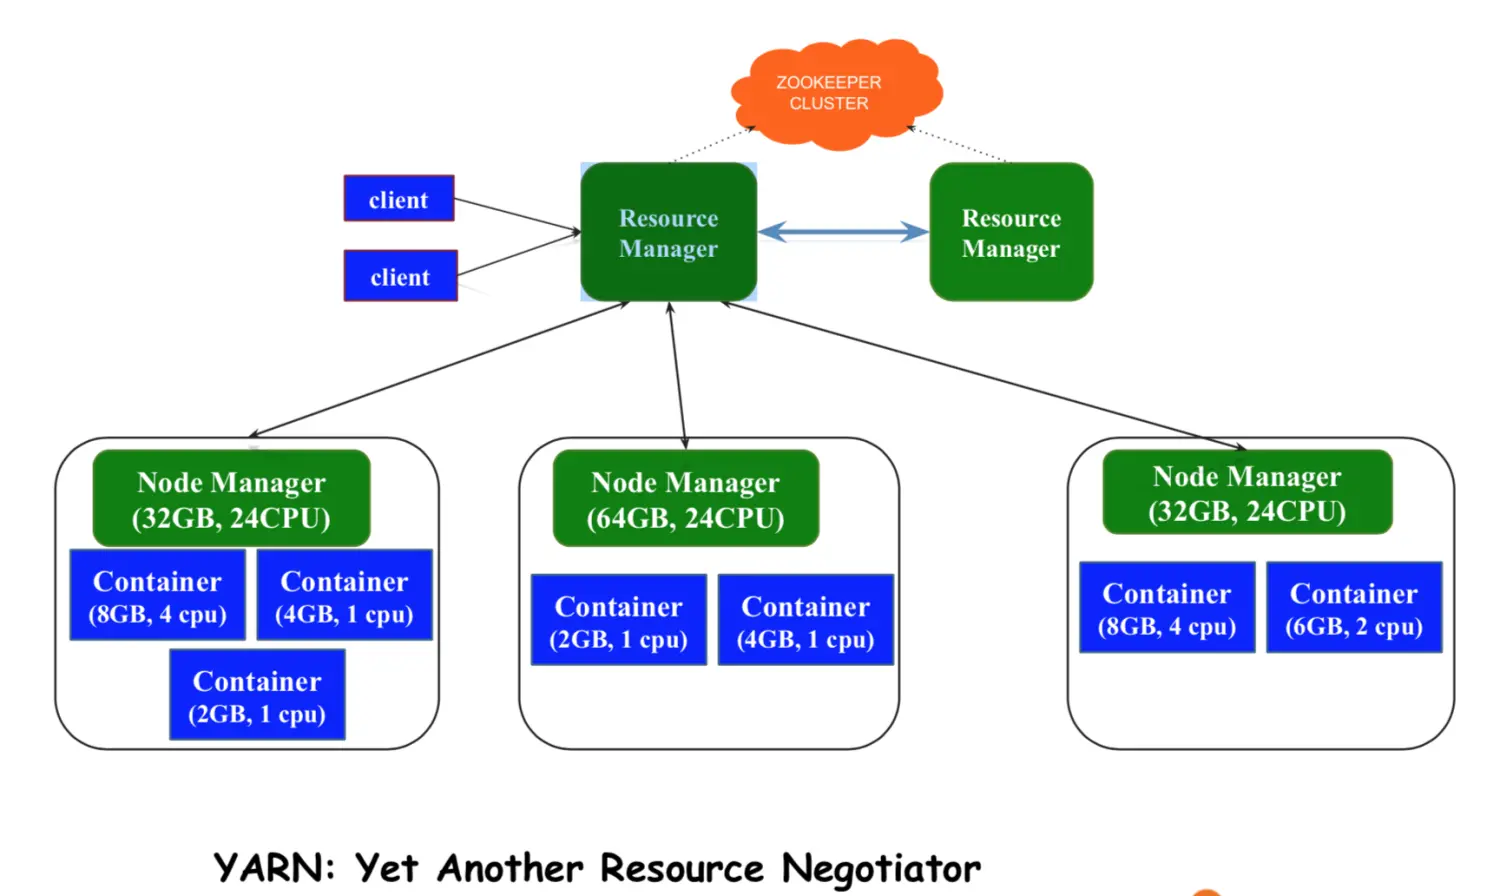
image.png
如上图,ResourceManager 和NodeManager组成了整个数据计算框架,在整个系统中,所有的应用程序所需的资源都由RM说了算,RM在这拥有至高无上的权利,NM是每台机器分配资源的代理人,NM负责监听资源的使用情况,包括(cpu、内存、磁盘、网络)并实时向RM汇报,每个应用程序的ApplicationMaster(AM)实际上是一个特别的框架,AM的任务是负责向RM申请所需资源,获取资源后跟NM一起合作执行并监督任务的完成情况。下面我们分别详细介绍各个模块的功能作用:
YARN的核心组件
- ResourceManager: 整个集群只有一个,负责集群资源的统一管理和调度,详细功能如下:
- 处理客户端请求
- 启动/监控ApplicationMaster
- 监控NodeManger
- 资源分配与调度
- NodeManger: 整个集群有多个,负责自己本身节点资源管理和使用,详细功能如下:
- 单个节点上的资源任务管理
- 处理来自ResourceManager的命令
- 协助ApplicationMaster处理任务,处理来自ApplicationMaster的命令
- 定时向RM汇报本节点的资源情况
- 管理着抽象的资源容器,这些容器代表着一个应用程序针对每个节点上的资源
- Container: YARN中的资源抽象,封装了该节点上的多维度资源,
- 封装了任务运行资源(节点、内存、cpu等)的一个容器
- 是一个任务运行环境的抽象,并且该任务只能使用该container中描述的资源
- ApplicationMaster: 管理应用程序在yarn上的每个实例,详细功能如下:
- 每个应用程序对应一个,MR、Spark, 负责应用程序的管理
- 为应用程序向RM申请资源(core、memory),并进一步分配给内部task
- 需要与NM通信,启动/停止 task, task是运行在container里面,AM也是运行在container里面
那么YARN框架相对于老的MapReduce框架有什么优势呢?
YARN作为一个资源管理系统,其最重要的两个功能就是资源调度和资源隔离,通过RM实现资源调度,隔离则有各个NM实现。资源调度指的是RM可以将某个NM上的资源分配给任务,而资源隔离则是NM按照任务需要提供相应的资源,保证这些资源的独占性,为任务运行提供保证。 在老的框架中,JobTracker很大的一个负担就是要监控job中task的运行情况,现在这部分由ApplicationMaster来完成。ResourceManager有两个主要组件:Scheduler和ApplicationsManager, ApplicationsManager用来监控ApplicationMaster的运行情况,如果出现问题,会在其他机器上重启
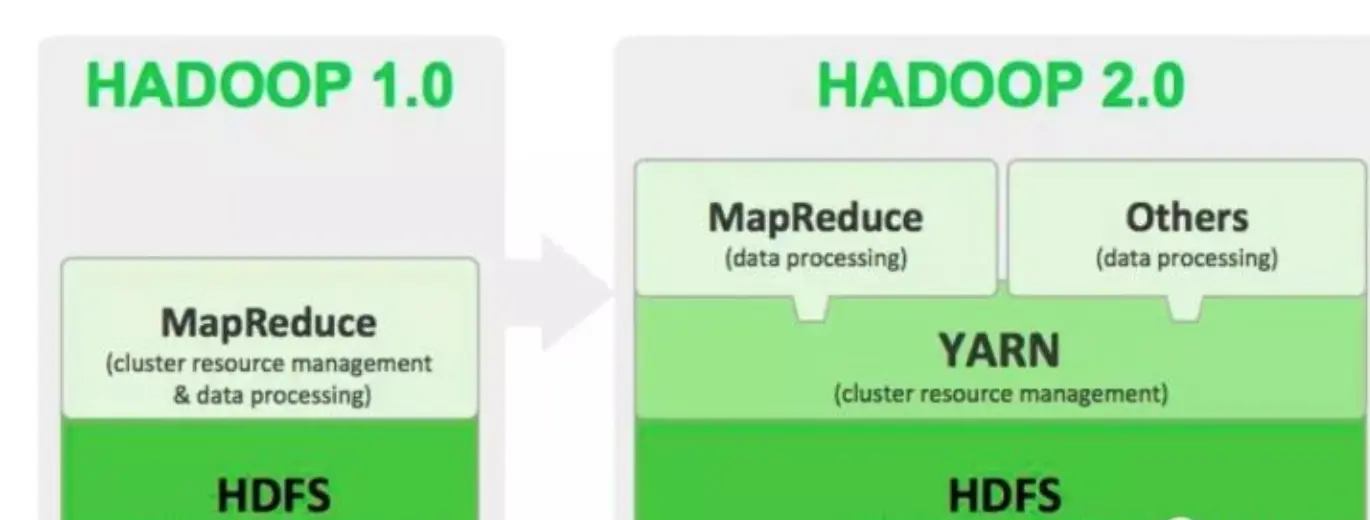
image.png
如上图所示,hadoop1.0 版本只支持 MapReduce 计算,而2.0多了 yarn 这个集群资源管理框架,这样的好处就是不同的计算框架(Spark/MapReduce/Storm/Flink)可以共享一个hdfs集群上的数据,享受整体的资源调度,按需分配,进而提高集群资源的利用率。这就好比yarn成为了 hadoop 的操作系统,只要你符合我的标准,就可以安装不同的软件。
yarn的执行流程
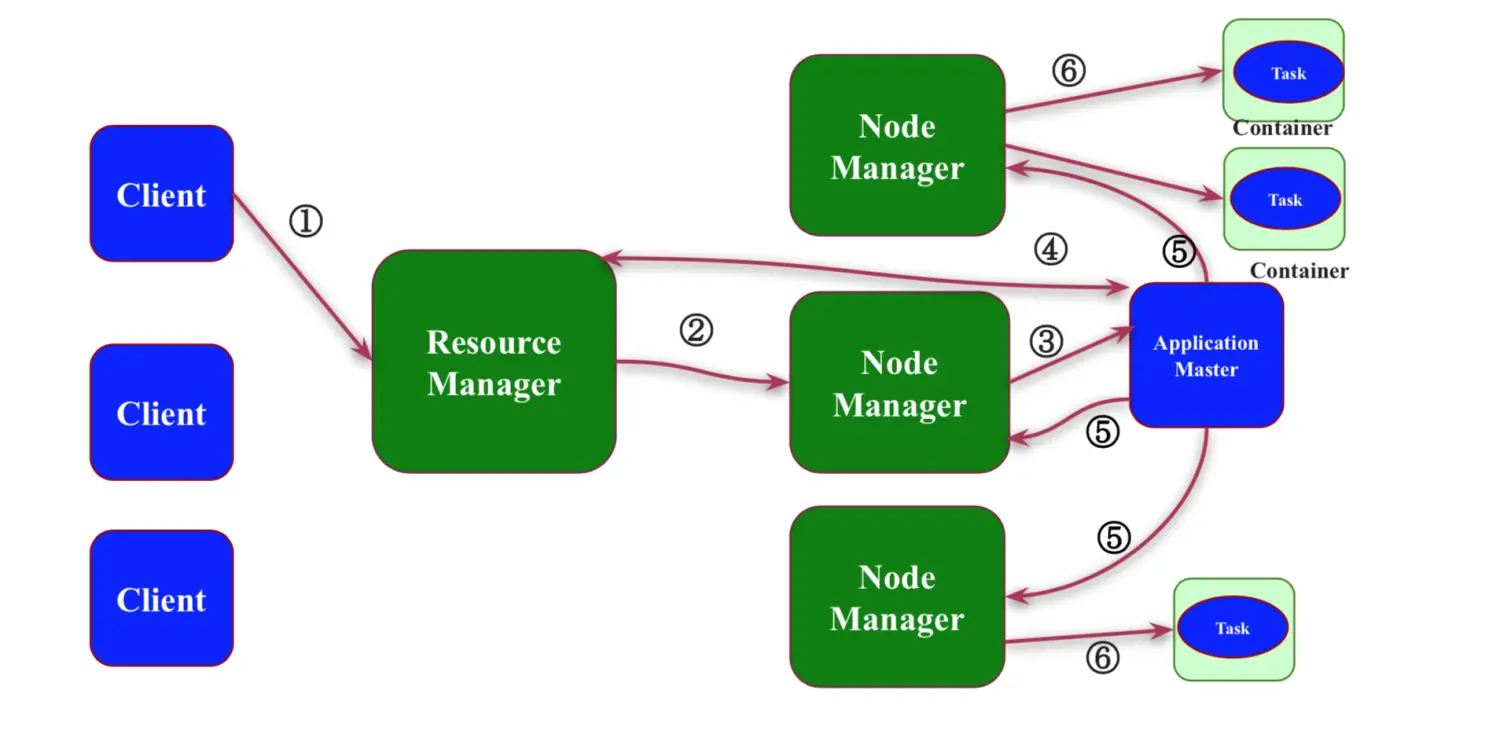
image.png
- 客户端向yarn提交作业,首先找RM分配资源;
- RM接收到作业后,会与相应的NM建立通信;
- RM要求NM创建一个Container来运行ApplicationMaster实例
- ApplicationMaster会向RM注册并申请所需资源,这样Client就可以通过RM获知作业运行情况
- RM分配给ApplicationMaster所需资源,ApplicationMaster在对应的NM上启动Container;
- Container启动后开始执行任务,ApplicationMaster监控各个任务的执行情况,并反馈给RM,
其中ApplicationMaster是可可插拔的,可以替换不同的应用程序
YARN容错性
- ResourceManager: 存在单点故障, 基于zk实现ha
- NodeManager : 失败后,RM将失败任务告诉对应的AM; AM决定如何处理失败的任务。
- ApplicationMaster, 失败后,由RM负责重启, AM需要处理内部任务的容错性问题, AM会保存已经完成的Task,重启后无需重新运行。
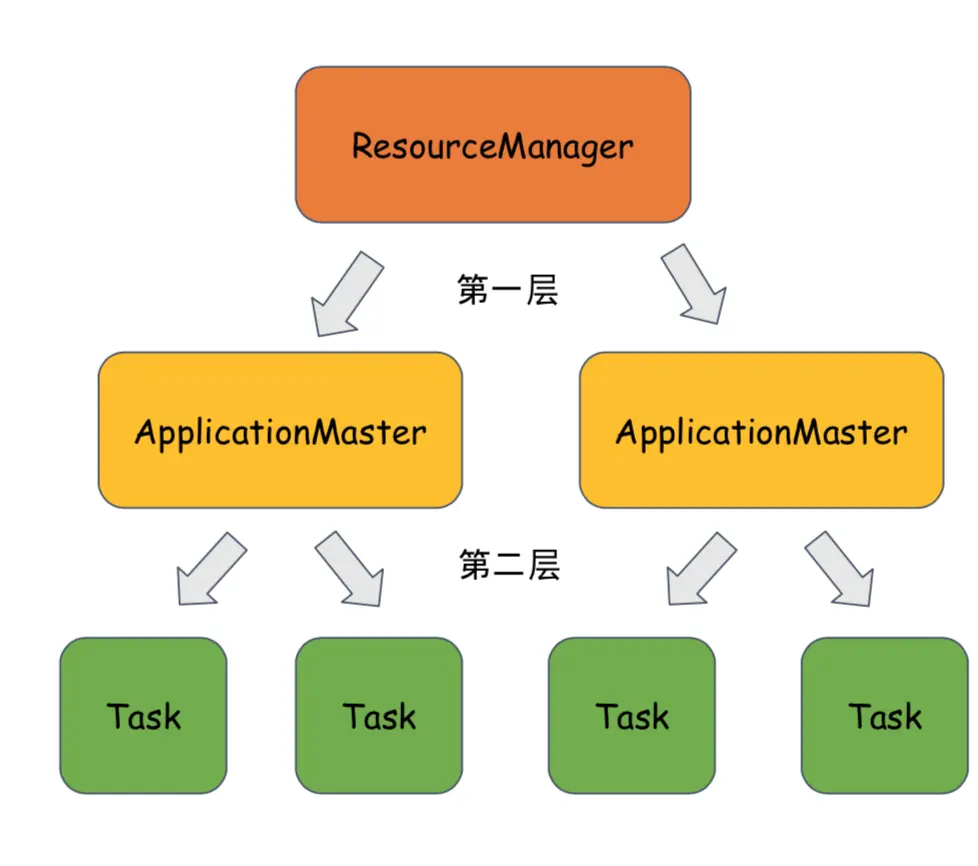
双层调度框架
- RM将资源分配给AM
-
AM将资源进一步分配给各个Task

image.png
YARN设计目标
- 通用的统一资源管理系统: 同时运行长应用程序和短应用程序
- 长服务:永不停止运行的程序
- 短作业: MRJOB, spark job等