map reduce原理
问题:怎样解决海量数据的计算?
- MapReduce是一种分布式计算模型,由Google提出,主要用于搜索领域,解决海量数据的计算问题.
- MR由两个阶段组成:Map和Reduce,用户只需要实现map()和reduce()两个函数,即可实现分布式计算,非常简单。
执行步骤
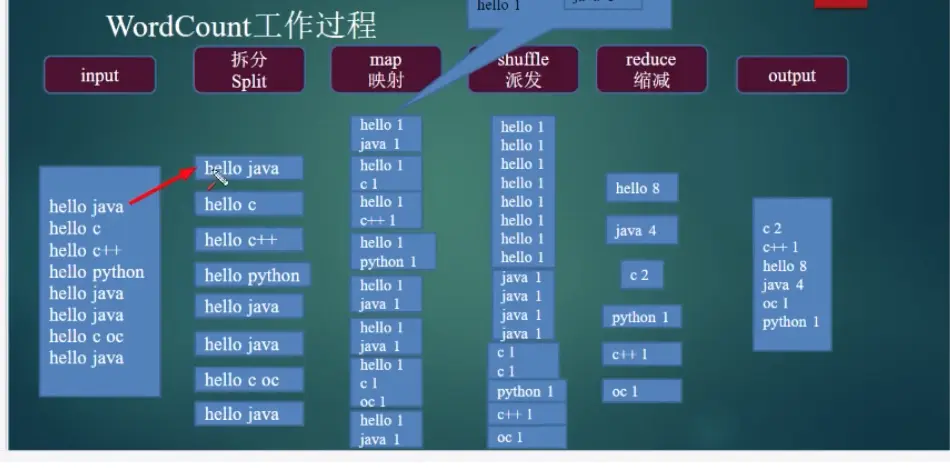
image.png
map任务处理
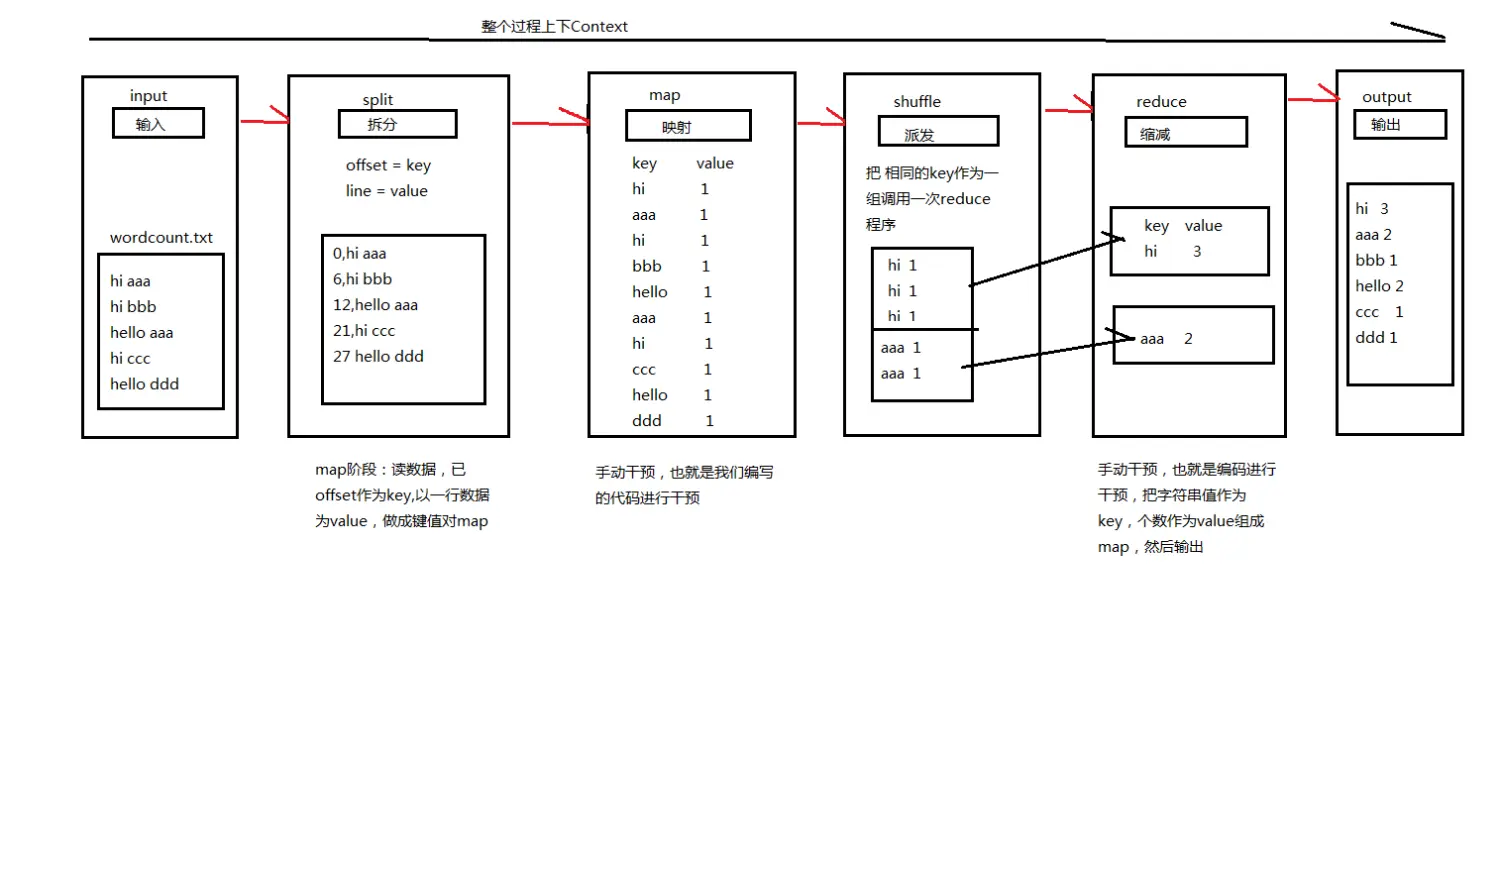
image.png
- 读取输入文件内容,解析成key、value对。对输入文件的每一行做拆分,默认拆分是key为每行的起始字节序号(拆分方式可以变化),value为每行的值。每一个键值对调用一次map函数。
- 写自己的逻辑,对输入的key、value处理,转换成新的key、value输出。
- 对输出的key、value进行分区,
- 对不同分区的数据,按照key进行排序、分组。相同key的value放到一个集合中。
- (可选)分组后的数据进行归约。
reduce任务处理
- 对多个map任务的输出,按照不同的分区,通过网络copy到不同的reduce节点。
- 对多个map任务的输出进行合并、排序。写reduce函数自己的逻辑,对输入的key、value处理,转换成新的key、value输出。
- 把reduce的输出保存到文件中
word count实例
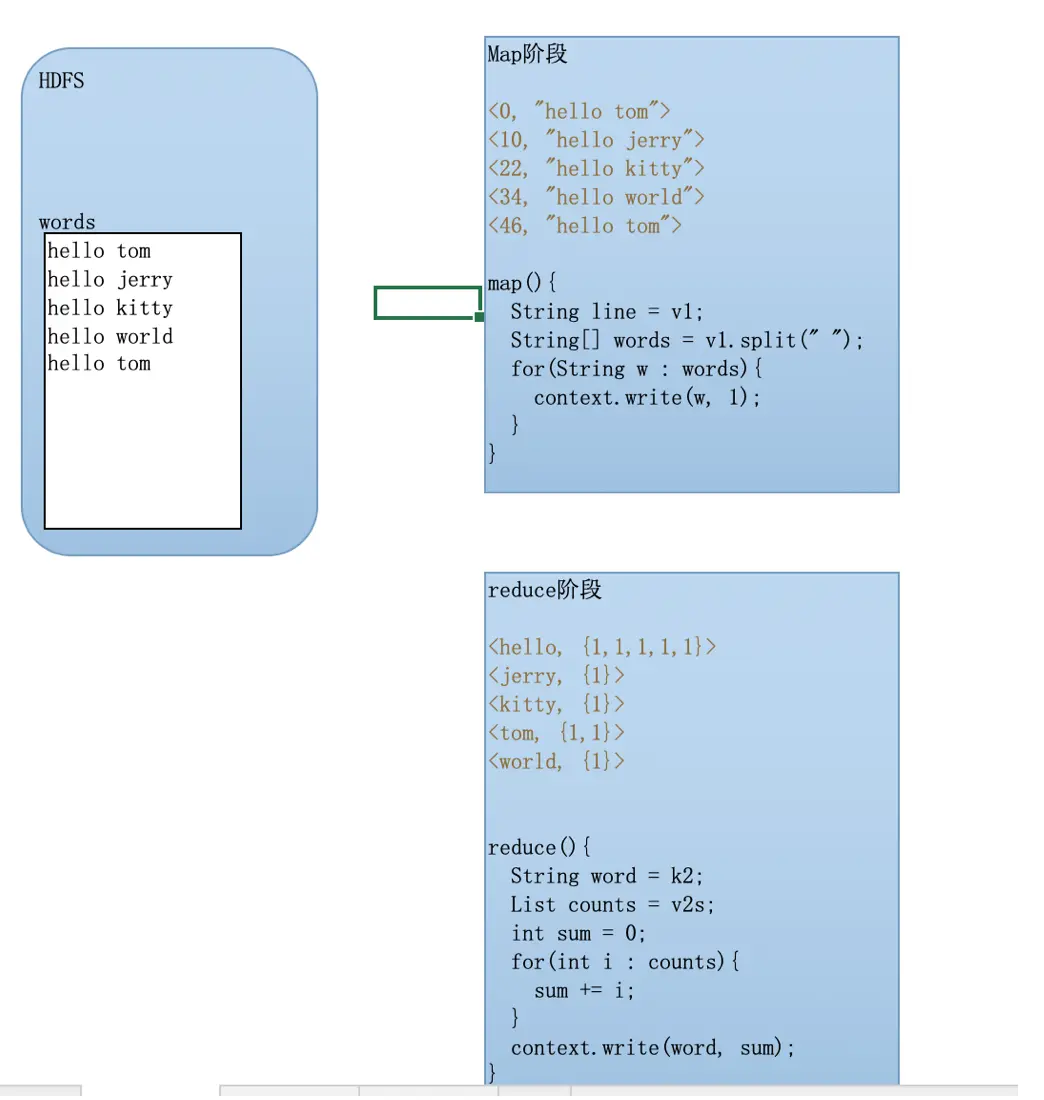
image.png
map代码:
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Mapper;

import java.io.IOException;

public class WCMapper extends Mapper<LongWritable, Text, Text, LongWritable> {

    @Override
    protected void map(LongWritable key, Text value, Context context)
            throws IOException, InterruptedException {
        //接收一行数据
        String line = value.toString();
        //分割
        String[] words = line.split(" ");
        //迭代
        for(String w : words){
            //发送
            context.write(new Text(w), new LongWritable(1));
        }
    }


}
reduce代码
import java.io.IOException;

import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Reducer;

public class WCReducer extends Reducer<Text, LongWritable, Text, LongWritable> {

    @Override
    protected void reduce(Text key, Iterable<LongWritable> v2s, Context context)
            throws IOException, InterruptedException {
        //定义一行计数器
        long sum = 0;
        //迭代他的次数
        for(LongWritable lw : v2s){
            //求和
            sum += lw.get();
        }
        //输出
        context.write(key, new LongWritable(sum));
    }


}
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;
import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;
/**
* 1.定义一个类,这个类是MR执行入口
* 2.定义一个类,这个类要继承org.apache.hadoop.mapreduce.Mapper,指定泛型的类型(k1,v1和k2,v2),然后重新map方法,接收数据,实现具体的业务逻辑
* 3.定义一个类,这个类要继承org.apache.hadoop.mapreduce.Reducer,指定泛型的类型(k2,v2和k3,v3),然后重新reduce方法,接收数据(k2和v2s,已经分组),实现具体的业务逻辑
* 4.在main方法中将自定义的mapper和reducer组装起来,提交
* 5.打包
* @author zx
*
*/
public class WordCount {
public static void main(String[] args) throws Exception {
// 构造一个Job对象,job对象要依赖Configuration
Configuration conf = new Configuration();
conf.set("mapreduce.framework.name", "yarn");
conf.set("yarn.resourcemanager.hostname", "itcast01");
Job job = Job.getInstance(conf);
//注意:要将main所在的类设置一下
job.setJarByClass(WordCount.class);
//设置Mapper相关的属性
job.setMapperClass(WCMapper.class);
job.setMapOutputKeyClass(Text.class);
job.setMapOutputValueClass(LongWritable.class);
FileInputFormat.setInputPaths(job, new Path(args[0]));
//设置Reducer相关属性
job.setReducerClass(WCReducer.class);
job.setOutputKeyClass(Text.class);
job.setOutputValueClass(LongWritable.class);
FileOutputFormat.setOutputPath(job, new Path(args[1]));
job.setCombinerClass(WCReducer.class);
//提交任务
job.waitForCompletion(true);
}
}详细代码见:worcount
idea 打jar包
-
选中Java项目工程名称,在菜单中选择 File->project structure…

image.png
-
在弹出的窗口中左侧选中”Artifacts”,点击”+”选择jar,然后选择”from modules with dependencies”。
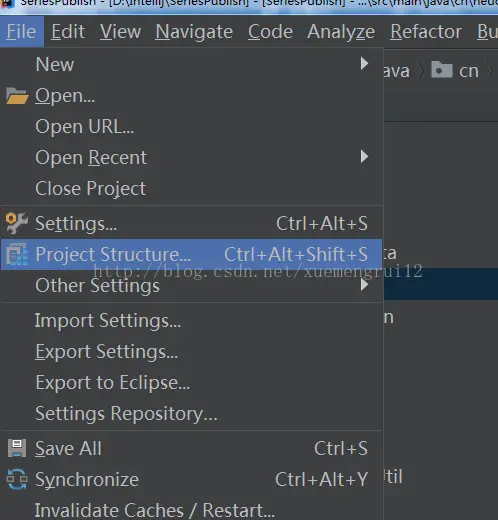
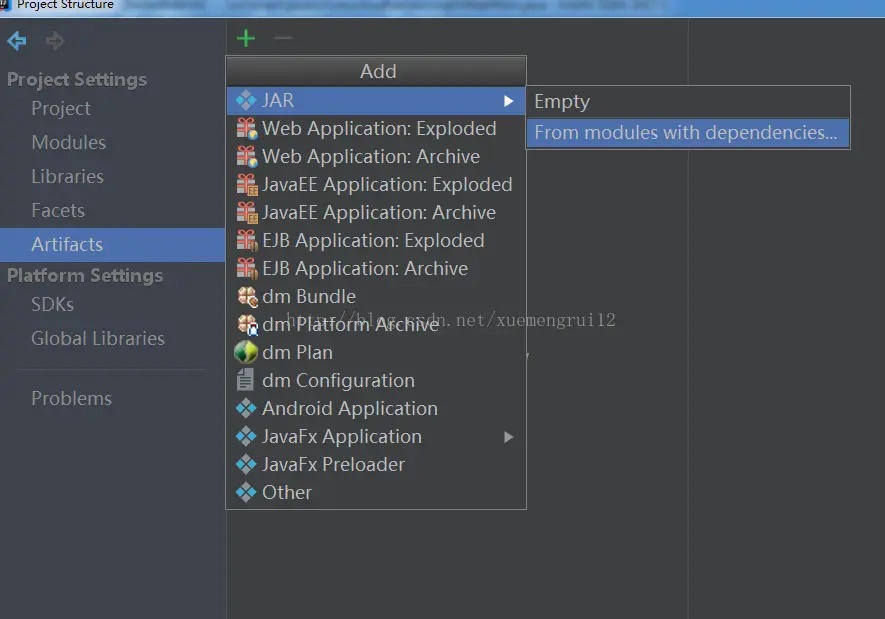
image.png
-
在配置窗口中配置”Main Class”。
image.png
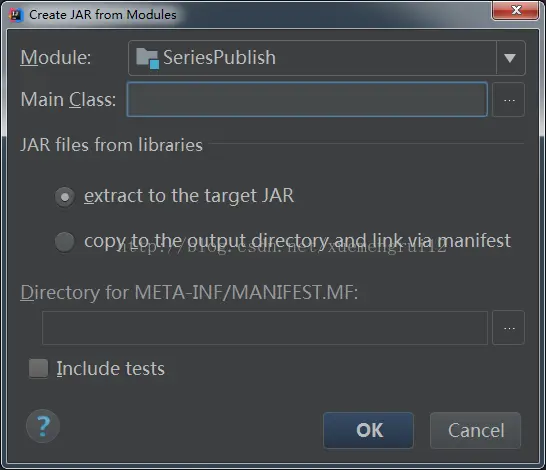
- 配置“Directory for META-INF/MAINFEST.MF”, 放在resource目录下
- 配置完成后如下图所示,点击OK进入下一步。我个人建议选择“extract to the target JAR”,这样所有依赖的jar包都会放在生成的jar包中。
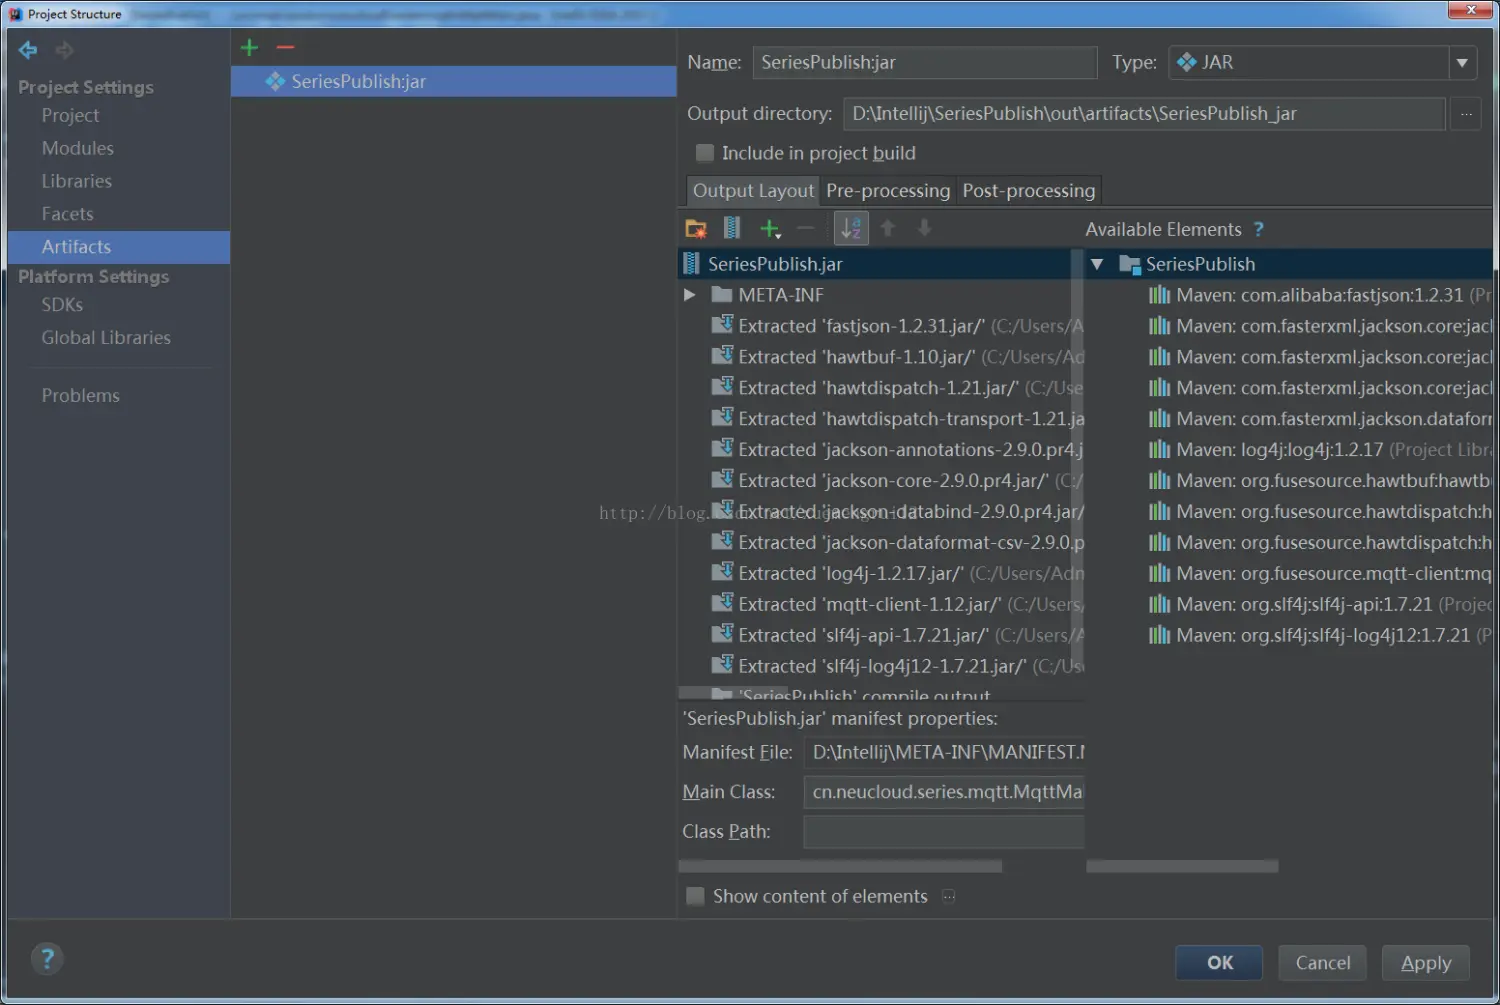
image.png
- 完成后,点击OK,Apply等按钮,回到IDEA的主菜单,选择“Build – Build Artifacts”下的“Build”或者“Rebuild”即可生成最终的可运行的jar,
上传wordCount.txt到hdfs: hadoop fs -put wordCount.txt
执行MR的命令:
hadoop jar <jar在linux的路径> <main方法所在的类的全类名> <参数>
例子:
hadoop jar mr.jar hdfs://server-2:9000/wordCount.txt /out2
得到结果:
 hadoop fs -cat /out2/part-r-00000
hard    1
hello   2
nihao   2
study   1
world   1
xxx  2
yes     1